


llms.txt ничего не запрещает и не разрешает, он только подсказывает ИИ, какие страницы важны. Google его не использует. Данные показывают, что почти никто файл не запрашивает, а эффект на ответы нейросетей не подтверждён. Реальная польза описана для сайтов с документацией, которую читают ИИ-инструменты для разработчиков. Остальным разумнее потратить время на то, что уже подтверждено работает — подробнее в статьях «Чем отличаются SEO, AEO и GEO» и «Как провести аудит видимости бренда в AI-поиске».
У Google есть официальный ответ на вопрос, нужен ли сайту файл llms.txt. В руководстве по генеративным функциям поиска, которое вышло 15 мая 2026 года, сказано, что для Google Search не нужно создавать машиночитаемые файлы, текстовые файлы для ИИ, разметку или Markdown, потому что поиск сам их не использует. Наличие такого файла не поможет и не навредит видимости и ранжированию.
В заголовках русскоязычных статей llms.txt часто называют файлом для управления нейросетями по аналогии с robots.txt. Это неточно. Индексацией и доступом управляет robots.txt, а llms.txt — предложенный в сентябре 2024 года markdown-файл с картой важных страниц сайта для ИИ. Разница между этими двумя файлами касается и классического SEO, и продвижения в нейросетях одновременно, поэтому в ней стоит разобраться, прежде чем тратить время на файл, который может не дать эффекта.
Что такое llms.txt и чем он не является
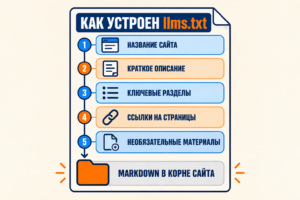
Это текстовый файл в формате Markdown, который лежит в корне сайта по адресу вида ваш-сайт.ru/llms.txt. В нём заголовок первого уровня с названием сайта, краткое описание цитатой, разделы второго уровня со ссылками на ключевые страницы и пояснениями, а также необязательный раздел для второстепенного. Существует и расширенный вариант llms-full.txt с полным содержанием страниц.
| Файл | Для чего | Управляет доступом |
|---|---|---|
| robots.txt | Правила сканирования для краулеров, которые их соблюдают | Да, рекомендательно |
| sitemap.xml | Список адресов для индексации | Нет, только подсказывает адреса |
| llms.txt | Курируемая карта важного контента в Markdown | Нет |

Ошибку про управление доступом встречаем и в русскоязычных материалах — файл иногда называют аналогом robots.txt для языковых моделей или описывают так, будто он управляет доступом LLM к информации. На деле файл задуман как шпаргалка для ИИ и не заменяет robots.txt. Если вы хотите закрыть сайт от ИИ-краулеров, нужен robots.txt, а не llms.txt.
Что говорят Google и другие
Позиции Google не противоречат друг другу. Поиск и браузерные инструменты — разные продукты: один проверяет готовность к агентам, другой ранжирует страницы. В декабре 2025 года файл ненадолго появился в документации Google для разработчиков, но представитель Google на вопрос, значит ли это поддержку, ответил отрицательно. Руководство Google касается самого Google и прямо оговаривает, что для других сервисов создавать файл можно.
| Кто | Позиция | Статус |
|---|---|---|
| Google Search, руководство от 15 мая 2026 года | Поиск файл не использует, наличие не поможет и не навредит, для других сервисов создавать файл можно | По пересказам нескольких изданий |
| Представитель Google | Сравнивал файл с метатегом keywords, отмечал, что ни одна ИИ-служба не заявила об использовании | По пересказам нескольких изданий |
| Chrome Lighthouse | В аудите готовности к ИИ-агентам есть проверка наличия llms.txt | По пересказам |
| Anthropic | Публикует собственный файл и рекомендует его для документации | По пересказам |
| Perplexity | В документации есть индекс llms.txt | По пересказу |
При этом ни OpenAI, ни Anthropic, ни Сбер с Яндексом официальную поддержку файла не подтверждали. Для Google это остаётся верным и сегодня — позиция других платформ может со временем измениться, поэтому любые выводы на эту тему стоит читать как снимок на конкретную дату, а не как постоянное правило.
Доводы сторонников и скептиков
Спор вокруг файла идёт не только о данных, но и об ожиданиях. Сторонники считают его полезным побочным продуктом документации, скептики — сырым и неподтверждённым экспериментом, который отнимает время без гарантированного результата. Обе позиции имеют право на существование, пока нет официальной поддержки от крупных нейросетей.
| Сторонники говорят | Скептики отвечают |
|---|---|
| Файл помогает обойти ограничение контекстного окна, давая ИИ готовую выжимку | Нет стандарта уровня RFC и нет обязательств вендоров ИИ следовать файлу |
| Это шанс явно указать ключевые страницы и задать фокус ответов о бизнесе | Парсеры и недобросовестные скрейперы файл всё равно игнорируют |
| Ранняя адаптация может стать конкурентным преимуществом | Схема, структура заголовков, robots.txt и sitemap.xml уже решают те же задачи |
| Низкая цена входа | Нужно поддерживать файл и следить за битыми ссылками, а сжатая выжимка может обеднить понимание |
Кому он может пригодиться
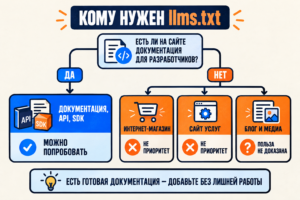
Прежде чем решать, ответьте себе на три вопроса. Есть ли у вас документация, которую читают разработчики и их ИИ-инструменты. Получится ли собрать файл без отдельной работы. Готовы ли вы его поддерживать, когда структура сайта изменится.
Практическое правило простое. Если файл получается из документации бесплатно, как побочный продукт, пусть будет. Если для него нужна отдельная работа, лучше потратить время на то, что подтверждено.
| Тип сайта | Стоит ли делать | Почему |
|---|---|---|
| Документация, API, SDK | Возможно | ИИ-инструменты разработки читают файл, если на него указать, и его можно собирать из того же конвейера, что документацию |
| Интернет-магазин, сайт услуг, блог | Не приоритет | Google файл не использует, данных об эффекте нет |
| Медиа и база знаний | Пользы не доказано | В одном из тестов рост на сайтах без файла объяснялся другими причинами |
| Сайт на конструкторе без доступа к корню | Не получится | На части конструкторов (например, Tilda) файл положить нельзя — нет доступа в корень |
Как создать файл, если вы решили
- Выберите несколько десятков ключевых страниц, которые вы хотите показать, а не весь сайт.
- Оформите их в Markdown: название сайта, цитата с описанием, разделы со ссылками и коротким пояснением к каждой.
- Положите файл в корень домена и проверьте, что он открывается по прямому адресу и отдаёт код 200.
- Для больших сайтов с документацией добавьте llms-full.txt.
- Обновляйте файл при изменении структуры, иначе в нём появятся битые ссылки.

Что делать вместо этого
Google в своём руководстве пишет, что оптимизация под генеративный поиск — это оптимизация под поиск, то есть всё тот же SEO. Страница должна быть проиндексирована и иметь право на сниппет, контент должен быть доступен для обхода, а специальной разметки и переписывания текста под ИИ не требуется.
Практически это значит проверить, что robots.txt не закрывает нужное, страницы индексируются, а ответы на вопросы клиентов лежат на страницах понятным текстом. Для остальных нейросетей полезнее собственный замер видимости, чем файл — методика описана в статье про аудит видимости в AI-поиске.
Что стоит отслеживать
Позиция может измениться, если крупная нейросеть опубликует документацию с поддержкой файла. Следите за обновлениями руководства Google и документации OpenAI, Anthropic, Perplexity, Яндекса и Сбера, а также за собственными серверными логами. Пока подтверждённой поддержки нет, и это главное, что нужно знать про llms.txt в октябре 2026 года.
Мифы и неточности
Вокруг llms.txt ходит несколько цифр без проверяемого источника — встречаются они в том числе в популярных русскоязычных гайдах.
| Утверждение | Статус |
|---|---|
| llms.txt повышает вероятность цитирования на 20-25 процентов | Источника нет, противоречит руководству Google и независимым тестам |
| GPTBot, ClaudeBot и PerplexityBot запрашивают /llms.txt перед обработкой страниц | Источника нет, по данным Ahrefs 97 процентов файлов не получили запросов вообще |
| llms.txt управляет доступом LLM к информации | Доступом управляет robots.txt, не llms.txt |
| Google не использует файл при классическом ранжировании | Заявление Google шире — оно касается и ИИ-функций поиска тоже |
| Число доменов с llms.txt выросло с 4088 до 36 120 за год | Источник не указан |
| Первые упоминания в ответах ИИ появляются через 3-10 дней после обновления файла | Измерений нет |
Частые вопросы
Управляет ли llms.txt индексацией нейросетями?
Нет, это распространённая путаница. Индексацией и доступом краулеров управляет robots.txt, а llms.txt лишь предлагает ИИ карту важных страниц. Файл ничего не запрещает, и закрыть сайт от ИИ-краулеров им нельзя. Если задача именно в этом, нужен robots.txt с правилами для нужных ботов.
Использует ли Google llms.txt?
Нет, и Google говорит об этом прямо. В руководстве по генеративным функциям поиска сказано, что поиск файлы такого типа не использует, а их наличие не поможет и не навредит видимости. Исключение касается только других сервисов, которые могут читать файл по собственным правилам.
Нужен ли llms.txt интернет-магазину или блогу?
Не приоритетно. Для Google он не работает, а подтверждённого эффекта на ответы других нейросетей нет. Если файл можно получить бесплатно из существующего процесса, это не повредит, но отдельная работа ради него не оправдана.
Как проверить, читает ли кто-то мой llms.txt?
Откройте серверные логи и поищите запросы к адресу файла — это самый надёжный способ проверить, интересуются ли им ИИ-сервисы. На практике большинство таких файлов за месяц не получают ни одного запроса, поэтому ждать быстрых результатов не стоит.
Может ли llms.txt навредить?
Сам файл не навредит видимости в поиске. Риски другие: время на создание и поддержку, а также то, что файл читают не только ИИ-сервисы — встречаются краулеры, изучающие такие файлы на предмет prompt injection, поэтому лишнего в нём быть не должно.
Что такое llms-full.txt и нужен ли он?
Расширенный вариант файла с полным содержанием ключевых страниц в одном документе. Полезен для документации и больших баз знаний. Подтверждённой пользы вне документации нет, поэтому для обычного сайта услуг он тем более не приоритетен.
Выводы
llms.txt остаётся экспериментом без подтверждённой поддержки крупных нейросетей и без какого-либо эффекта на Google Search. Для сайта с открытой документацией для разработчиков файл можно собрать почти бесплатно как побочный продукт — хуже не будет. Для обычного коммерческого сайта время разумнее вложить в то, что уже подтверждено: индексацию, структуру страниц и прямые ответы на вопросы аудитории прямо в тексте.

